

آموزش Splunk در این صفحه، راهنمایی عملی و جامع است برای هر کسی که میخواهد از جمعآوری لاگ تا تحلیل پیشرفته و ساخت داشبوردهای حرفهای را بهصورت مرحلهبهمرحله یاد بگیرد. ابتدا میفهمید Splunk چیست و چگونه دادهها را ایندکس میکند، سپس نصب، ورود دادهها (UF/HEC)، پارسینگ (props/transforms)، جستجو با SPL، و در نهایت آلارم، امنیت، و مقیاسپذیری را تمرین میکنید. با مثالهای واقعی (مثل Nginx) و نکات بهینهسازی (tstats، Acceleration) پیش میروید تا سریعتر و دقیقتر تحلیل کنید. اگر دنبال یک مرجع فارسی عمیق برای Splunk هستید، از همینجا شروع کنید.
فهرست مطالب
1. Splunk چیست و چه مسألهای حل میکند؟
Splunk یک پلتفرم Observability و Analytics دادههای رویدادی است که لاگها، متریکها و رخدادها را از منابع متنوع جمعآوری، ایندکس و قابلجستجو میکند. خروجی: جستوجوی سریع، بصریسازی، آلارم و کشف الگو/ناهنجاری برای تیمهای DevOps، SecOps و BizOps.
2. معماری Splunk (اجزای اصلی و نقشها)
Universal Forwarder (UF): عامل سبک برای جمعآوری و ارسال لاگ از سرورها/کانتینرها.
Heavy Forwarder (HF): عامل با قابلیت پردازش (پارس/فیلتر/مسیردهی) قبل از ایندکس.
Indexer: دریافت، پارس، ایندکس و ذخیرهسازی دادهها؛ پاسخگوی اولیه به جستجو.
Search Head (SH): رابط کاربری، مدیریت جستجوها/داشبوردها/آلارمها.
Deployment Server / Cluster Master / Deployer / Monitoring Console: اجزای مدیریتی.
3. مدل لایسنس و مفاهیم داده
مدل لایسنس: معمولاً بر اساس حجم ورودی روزانه.
Index: فضای منطقی ذخیرهسازی (مثلاً
main،web,security).Sourcetype: الگوی فرمت داده (مثلاً
access_combinedیاjson).Host/Source: منشأ فیزیکی/مسیر فایل.
Bucket Lifecycle: hot → warm → cold → (اختیاری) frozen.
4. نصب Splunk Enterprise و راهاندازی اولیه
Linux (خلاصهٔ عملی):
# 1) ایجاد کاربر اختصاصی
sudo useradd -m splunk
sudo su – splunk
# 2) نصب (فرض: بستهٔ .tgz در /opt)
cd /opt
tar -xzf splunk-<version>-linux.tgz
/opt/splunk/bin/splunk start –accept-license
# 3) ساخت کاربر ادمین و ورود به وب
# وب UI پیشفرض: http://<host>:8000
Windows: نصبگر را اجرا کنید، سرویس Splunk را بهعنوان Service Account امن نصب کنید، پورت 8000 را بررسی کنید.
تنظیمات اولیهٔ حیاتی:
تغییر پورتها در صورت نیاز، فعالسازی SSL برای UI، زمانبندی پشتیبانگیری از کانفیگها.
5. ورودی دادهها (Data Onboarding)
5.1 فایل/دایرکتوری
در UI: Add Data → Monitor → Files & Directories
نکته:sourcetypeصحیح، تعیینindexاختصاصی.5.2 Syslog
ارسال از سرورها به HF/Indexer (پورت UDP/TCP).
برای حجم بالا: TCP و صفبندی؛ چرخش لاگ و محدود کردن نرخ.
5.3 HEC (HTTP Event Collector)
در Settings → Data Inputs → HTTP Event Collector: یک Token بسازید.
ارسال نمونه (cURL):
curl -k https://splunk:8088/services/collector \
-H “Authorization: Splunk <TOKEN>” \
-d ‘{“event”:”hello”,”sourcetype”:”my_json”,”host”:”web-1″,”fields”:{“env”:”prod”}}’
5.4 سایر
دیتابیسها (DB Connect)، کلود (S3، GCS)، کانتینر/کوبِرنِتِس (UF + HEC)، متریکها (StatsD/TELEGRAF→HEC).
6. نرمالسازی و پارسینگ: props.conf و transforms.conf
اهداف: زمان، جداسازی رویداد، استخراج فیلد، روتینگ/ریرایت.
$SPLUNK_HOME/etc/system/local/props.conf (یا در اپ اختصاصی):
[my_nginx]
SHOULD_LINEMERGE = false
TIME_FORMAT = %d/%b/%Y:%H:%M:%S %z
TIME_PREFIX = \[
LINE_BREAKER = ([\r\n]+)
TRUNCATE = 100000
REPORT-extract = my_nginx_fields
transforms.conf:
[my_nginx_fields]
REGEX = ^(?P<client>[^ ]+) [^ ]+ [^ ]+ \[(?P<time>[^\]]+)\] “(?P<method>\w+) (?P<uri>[^”]+) HTTP/(?P<httpver>[^”]+)” (?P<status>\d{3}) (?P<bytes>\d+)
FORMAT = client::$1 time::$2 method::$3 uri::$4 httpver::$5 status::$6 bytes::$7
نکتهٔ حرفهای: تا حد ممکن از sourcetype استاندارد (مثل access_combined) استفاده کنید تا با CIM سازگار باشید.
7. زبان جستجو (SPL): از مقدماتی تا پیشرفته
7.1 اصول
index=web sourcetype=access_combinedstatus>=500 earliest=-24h@hlatest=now | stats count bystatus uri | sort - countsearch/فیلتر اولیه، سپس Pipe به دستورات آماری/تبدیلی.
7.2 دستورات کلیدی
فیلترینگ:
search,where,fields,dedupتبدیل/محاسبه:
eval,replace,coalesce,split,mvexpandآمار:
stats,eventstats,streamstats,timechart,chartپردازش متن/JSON:
rex,spath,replace,matchترنزاکشن/سشن:
transaction(محتاطانه برای هزینهٔ محاسباتی بالا)، جایگزین باstats+streamstatsLookup/KV:
lookup,inputlookup,outputlookupکارایی:
tstatsروی Data Modelهای شتابگرفته،accelerate،summary indexing.
7.3 الگوهای پرکاربرد
نرخ خطای 5xx به تفکیک سرویس/مسیر:
index=web sourcetype=access_combinedstatus>=500 | bin _time span=5m | stats count aserrors by _time uri | timechart span=5msum(errors) by uri limit=10Anomaly Detection ساده با z-score:
index=web sourcetype=access_combinedstatus=200 | bin _time span=5m | stats count ashits by _time | eventstats avg(hits) as avgstdev(hits) as stdev | evalz=(hits-avg)/stdev | where z>3تحلیل JSON (مثلاً لاگ اپلیکیشن):
index=app sourcetype=my_json
| spath
| stats count by level component error.code |where level="ERROR"
8. Lookups، KV Store، CIM و Data Models
CSV Lookup: تطبیق شناسهها با توضیحات/تگها.
KV Store: ذخیرهٔ کلید-مقدار پایدار برای پیکرهبندی/وایتلیست/بلکلیست.
CIM (Common Information Model): استانداردسازی فیلدها برای اپهای امنیتی/مانیتورینگ.
Data Model & Acceleration: ایجاد لایهٔ تحلیلی و استفاده از
tstatsبرای سرعت بالا.
نمونهٔ tstats:
| tstats count where index=web by host, sourcetype9. داشبوردسازی
9.1 Classic (SimpleXML)
پنلها،
base searchوpost-processبرای صرفهجویی منابع.توکنها (tokens) برای فیلتر پویا.
9.2 Dashboard Studio
UI مدرن با ویجتهای غنی و JSON-based.
بهترینروش: جداسازی لایهٔ جستوجو (saved searches) از لایهٔ ارائه.
10. آلارمها و Scheduled Searches
Trigger Conditions: آستانهها، تغییرات درصدی، ناهنجاری.
Actions: ایمیل، وبهوک، ServiceNow/Jira، نوشتن به Index.
Throttling: جلوگیری از اسپم آلارم.
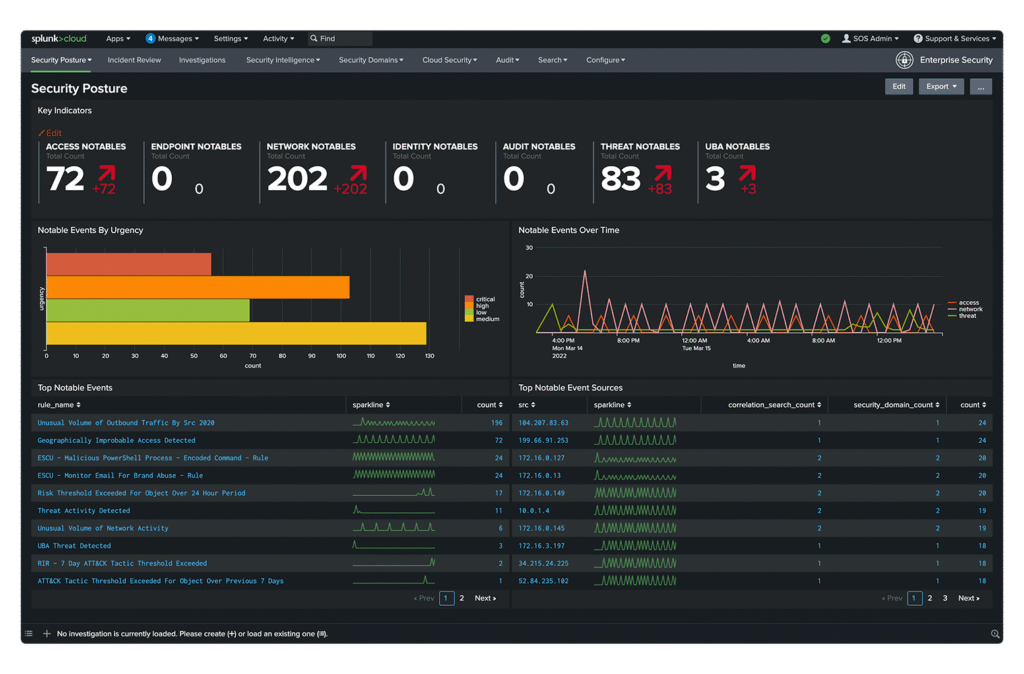
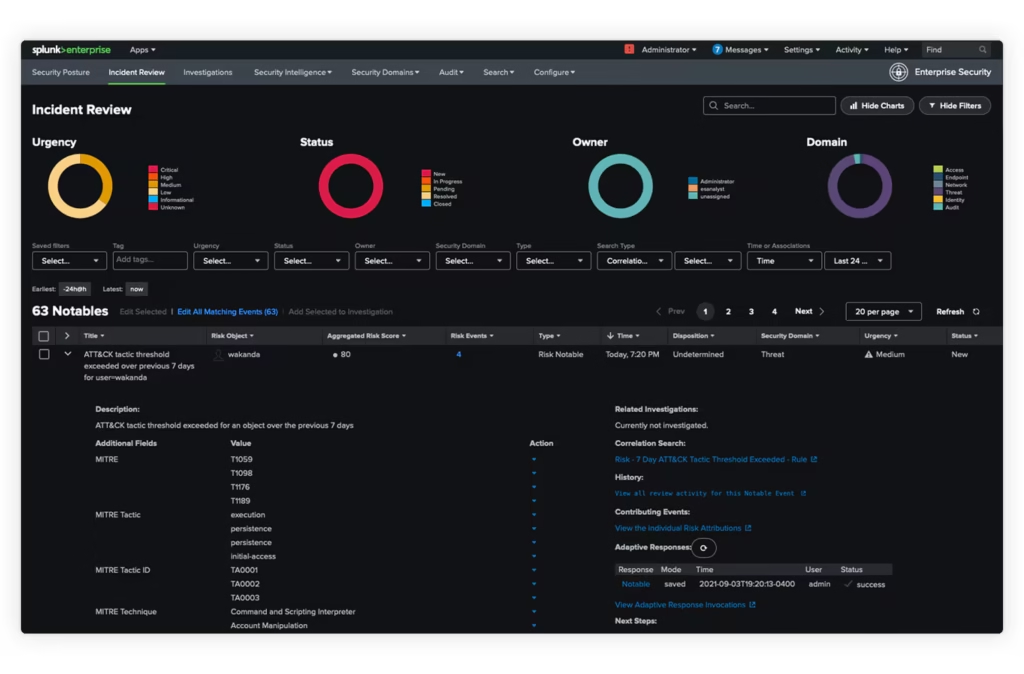
Notable Events: در سناریوهای امنیتی/ES.
11. امنیت و دسترسی
RBAC: نقشها → قابلیتها → دسترسی به Indexها.
HEC Tokens: حداقل سطح دسترسی، چرخش دورهای، محدودیت سورس/اندپوینت.
TLS: برای UI و HEC فعال کنید؛ گواهی معتبر.
Secrets Management: محافظت از گذرواژهها و credها.
12. مقیاسپذیری و High Availability
Indexer Clustering: کپیبرداری داده (Replication Factor) و جستجوپذیری (Search Factor).
Search Head Clustering: هماهنگی اشیای دانشی/جستجوها بین SHها.
Multisite: تابآوری بین دیتاسنترها.
Partitioning منطقی: ایندکسهای جدا برای محیطها/دامنههای لاگ.
13. بهینهسازی کارایی
Guidelines جستجو: فیلتر با
index/sourcetype، محدود کردن بازهٔ زمانی،fieldsبرای کاهش payload.Acceleration: Report/Data Model Acceleration، Summary Indexing.
Metrics Index: برای متریکها از
mstatsاستفاده کنید (فشرده، سریع).Base + Post-Process: یک جستجوی سنگین → چند پنل سبک.
Sampling:
sample/headبرای تست.
14. مانیتورینگ و عیبیابی
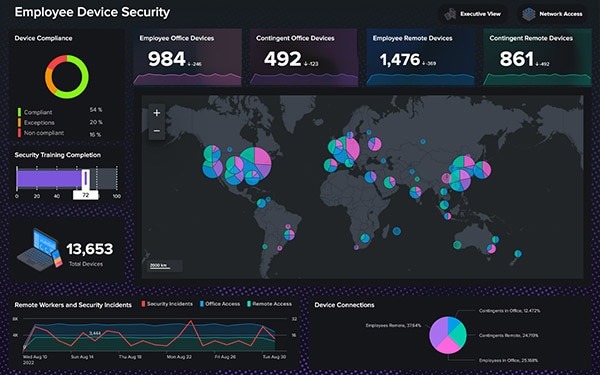
Monitoring Console (DMC): سلامت ایندکسر/سرچهد، تاخیر ایندکس، خطاها.
btool: تشخیص منبع نهایی کانفیگها.
$SPLUNK_HOME/bin/splunkbtool props list my_nginx --debugdiag: بستهٔ عیبیابی برای پشتیبانی.
splunk diaginternal logs: ایندکسهای
_internal,_auditبرای بررسی مشکلات و کارایی.
15. پروژهٔ عملی: از Nginx تا داشبورد و آلارم
هدف: نرخ ارور، کندی پاسخ، و نقاط داغ ترافیک را نظارت کنیم.
15.1 ورود داده
روی سرور وب UF نصب کنید و مسیر
access.log/error.logرا مانیتور کنید.sourcetype=access_combinedوindex=webتعیین کنید.
15.2 نرمالسازی
در
props.confزمان/line breaking را تثبیت کنید.در صورت JSON در
error.logازINDEXED_EXTRACTIONS=jsonیاspathدر سرچ استفاده کنید.
15.3 داشبورد (Widgetها)
KPIها:
RPS, نرخ5xx, میانگینbytes, توزیعstatus.Top URIs, Top Clients, Latency percentiles (اگر زمان پاسخ را دارید).
index=web sourcetype=access_combined
|
eval is_error=if(status>=500,1,0)
| bin _time span=1m
| stats count as rps sum(is_error) as errors avg(bytes) as avg_bytes by _time| eval err_rate=round(100*errors/rps,2)
15.4 آلارم
اگر
err_rate > 2%بهمدت 10 دقیقه → ایمیل/وبهوک.Throttle: 30 دقیقه.
15.5 تحلیل ناهنجاری
index=web sourcetype=access_combined status>=500
| bin _time span=5m
| stats count as errors by _time uri
| eventstats avg(errors) as avg stdev(errors) as sd by uri
| eval z=(errors-avg)/sd
| where z>316. چکلیست Best Practices
برای هر دامنهٔ داده index اختصاصی و retention متناسب.
sourcetypeاستاندارد و سازگار با CIM انتخاب کنید.تا میتوانید پارس را در ایندکس انجام دهید (پایداری و کارایی بهتر).
برای داشبوردها از saved searches و base search استفاده کنید.
آلارمها را با Throttle و متن عملیاتی (Playbook) تنظیم کنید.
بهطور منظم DMC را بررسی و capacity planning داشته باشید.
نسخه/اپها را در App اختصاصی نگهداری و ورژنگذاری کنید (Git).
دسترسیها را با RBAC حداقلی مدیریت کنید؛ Tokenها را بچرخانید.
برای متریکها بهجای لاگ از metrics index بهره ببرید.
کانفیگها را با btool اعتبارسنجی و با diag پشتیبانگیری کنید.
17. پرسشهای پرتکرار (FAQ)
Splunk Enterprise vs Splunk Cloud؟
Cloud مدیریت زیرساخت را بر عهده میگیرد؛ Enterprise انعطاف و کنترل کامل On-Prem میدهد.
Universal Forwarder یا Heavy Forwarder؟
UF سبک و پرکاربرد است؛ اگر قبل از ایندکس به پارس/مسیردهی پیچیده نیاز دارید HF.
چه زمانی transaction مناسب است؟
برای همبندی رویدادهای مرتبط (مثل شروع/پایان سشن). در اغلب موارد stats/streamstats کاراتر است.
tstats چه مزیتی دارد؟
روی Data Modelهای شتابگرفته جستجو میکند؛ بسیار سریعتر از stats روی raw events.
